logo level
KMO
Agency
Grote onderneming
contactOperationeelcontrolepaneel

Redundantie in onze webhosting

Hoe voorkom je server downtime? Maak je je zorgen over onverwachte storingen? In de wereld van hosting is ‘redundantie’ hét antwoord op onzekerheid over uptime. Maar net zoals bij alle dingen in het leven, komt ook redundantie met nuances en afwegingen. Bij Level27 helpen we je de juiste vorm van redundantie uit te kiezen, niet zomaar ‘meer is beter’, maar wel: wat past best bij jouw applicatie?

image

Wat is redundantie eigenlijk?

Redundantie betekent dat je hostingomgeving opgebouwd is met een failover-mechanisme. Concreet betekent dit dat redundantie fungeert als een soort van failsafe: wanneer één component uitvalt, neemt het failover-mechanisme het automatisch en naadloos over. Zo blijft de dienstverlening operationeel, zonder downtime of storingen.

Dit wordt gerealiseerd door gebruik te maken van meerdere stroombronnen, netwerkverbindingen, servers en soms zelfs volledige datacenters die parallel functioneren of standby staan.

Een redundant systeem kan zekerheid in uptime garanderen doordat het draait op gescheiden fysieke infrastructuren, vaak verspreid over meerdere datacenters en m.b.v. meerdere virtuele machines (VM’s). Het redundante systeem is dus zodanig opgesteld dat er geen single point of failure bestaat.

Je vraagt je nu misschien af: ‘Welke soorten redundante systemen bestaan er eigenlijk, en wat zijn de verschillen?’. Geen zorgen, bij Level27 leggen we het je graag uit.

Single Setup

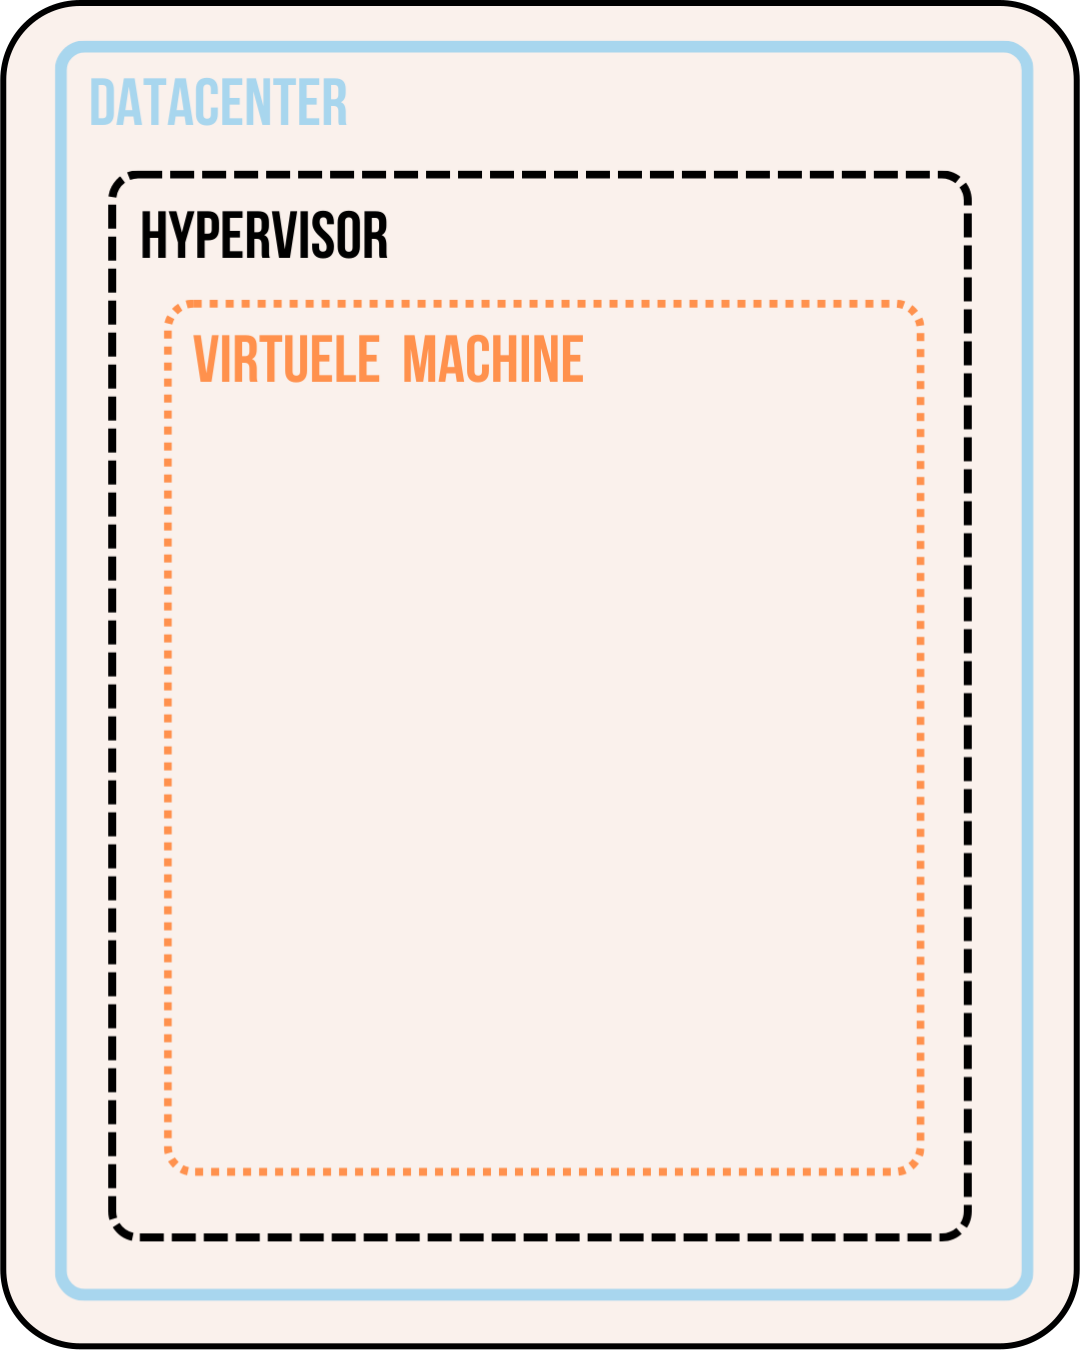
Je applicatie draait op één server in een datacenter, gehost op wat wij een primaire hypervisor noemen. Deze heeft standaard al ingebouwde redundantie, zoals meerdere stroombronnen, netwerkkaarten en storage disks. Valt bijvoorbeeld een netwerkkaart uit of gaat een storage disk stuk, dan nemen andere componenten het over en blijft je applicatie werken. Gaat de hypervisor zelf onderuit, dan kunnen alle virtuele machines herstart worden op een secundaire hypervisor, waar data met regelmaat wordt gesynchroniseerd. Het opstarten van deze backup kost tijd en bijgevolg bestaat het risico dat de laatste transacties van gebruikers verloren gaan.

image

Redundant Setup op één locatie

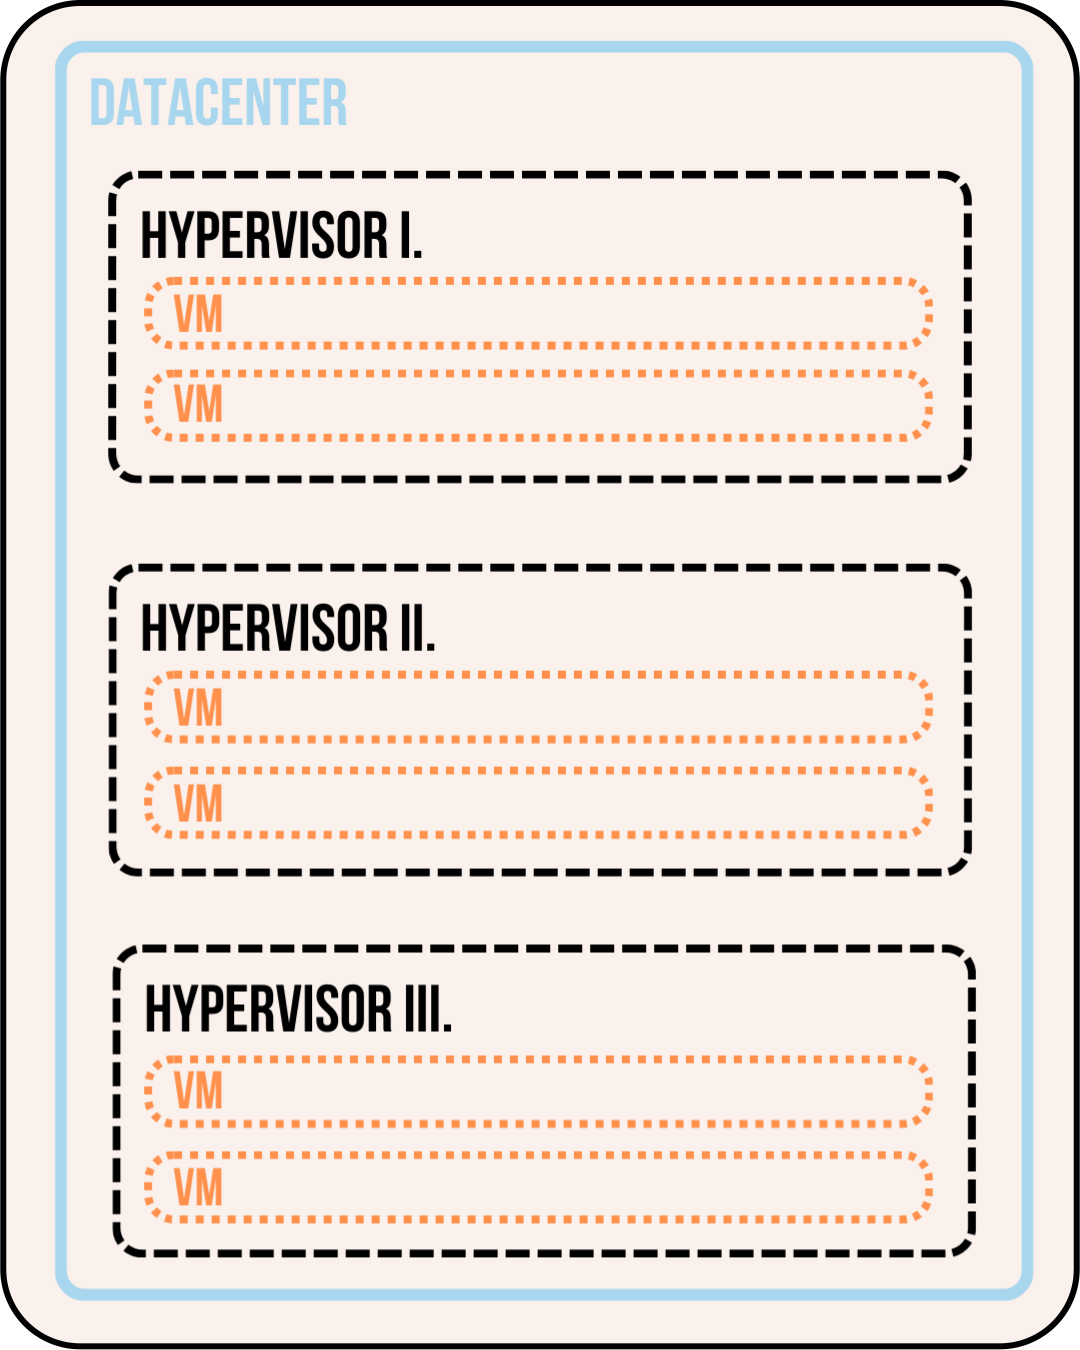
Deze setup bouwt voort op het single model, maar met een belangrijk verschil. Je applicatie wordt gehost op meerdere virtuele machines, verspreid over verschillende fysieke hypervisors binnen eenzelfde datacenter. Hierdoor is je omgeving resistent tegen het uitvallen van één virtuele machine, bijvoorbeeld door overbelasting of een configuratiefout. Een andere virtuele machine neemt automatisch het werk over, zodat de applicatie zonder onderbreking blijft werken. Daarnaast bieden de meerdere hypervisors extra bescherming. Mocht een hele hypervisor uitvallen, dan nemen de virtuele machines op de andere hypervisor de taken direct over. Dit maakt de setup betrouwbaar op het gebied van failover en beschermt tegen problemen op het niveau van virtuele machines of hypervisors. Toch blijft er een beperking, deze redundantie beschermt enkel tegen hardware- of hypervisor problemen. Zo blijft de afhankelijkheid van één datacenter een risico. Bij stroompanne, brand of netwerkstoring vallen al je systemen alsnog uit.

image

Redundant Setup op meerdere locaties

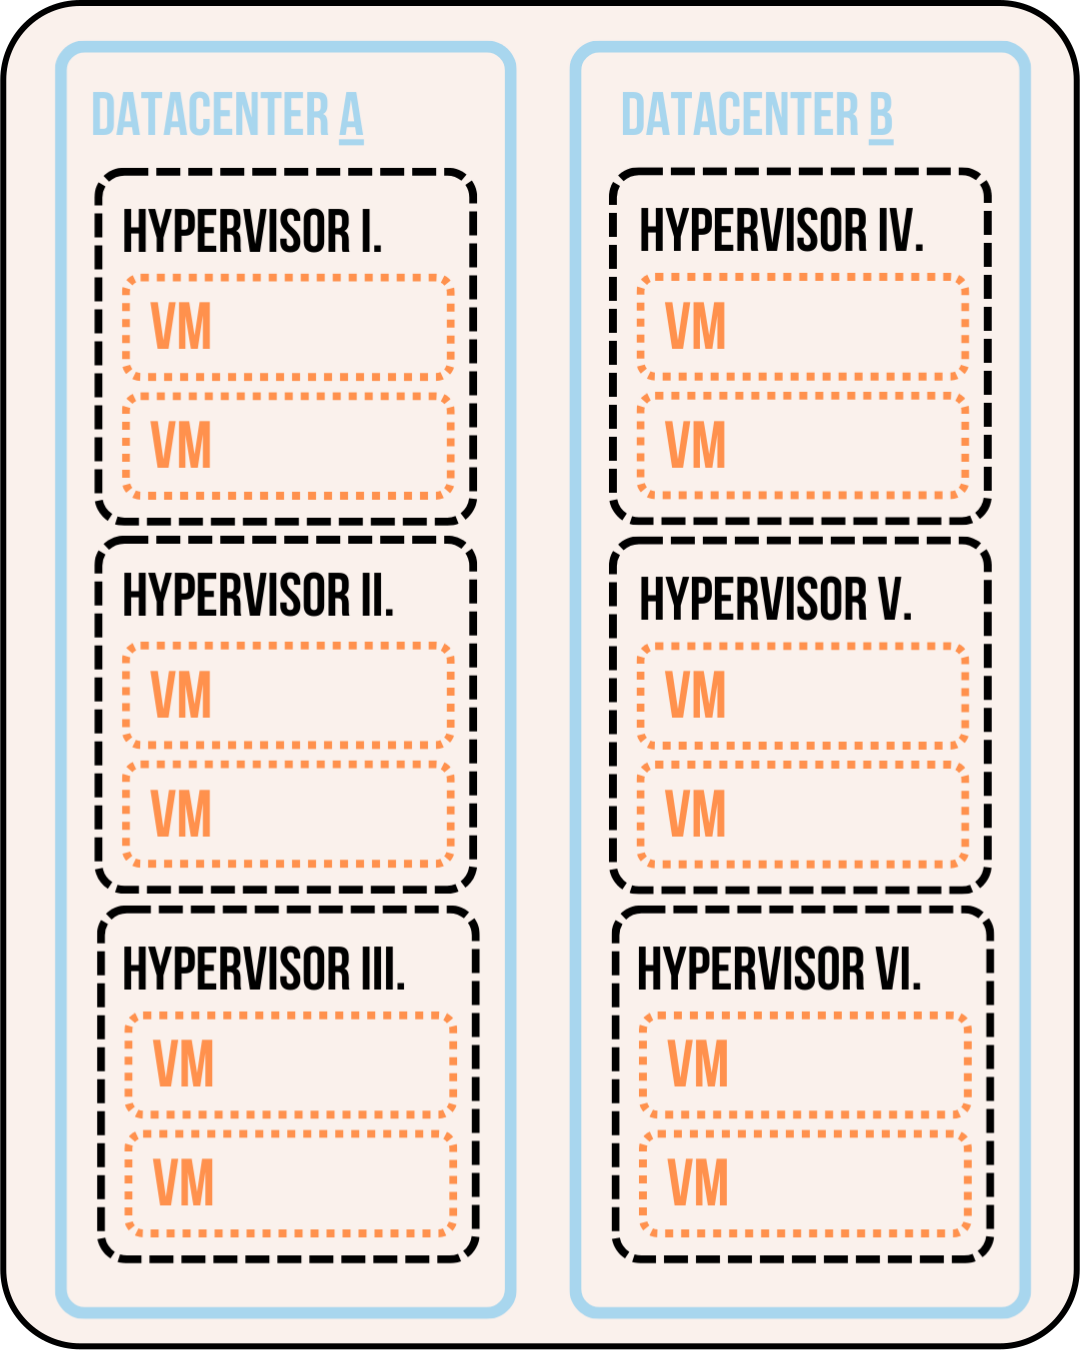
Hier worden redundante systemen verdeeld over meerdere datacenters die zich in verschillende geografische locaties bevinden. Zo draait je applicatie bij dit model bijvoorbeeld zowel in een datacenter in Brussel als in een datacenter in Antwerpen. Dankzij deze geografische scheiding blijft je applicatie operationeel, zelfs als een volledig datacenter plots onbeschikbaar wordt. Logischerwijs zou je natuurlijk kiezen voor een redundant systeem op meerdere locaties, toch? Helaas is dit systeem geen wondermiddel en brengt dit ook negatieve gevolgen met zich mee…

image
image1301

De keerzijde van redundantie

Redundantie klinkt als een no-brainer: meer zekerheid, minder risico. Maar ook dit concept heeft zijn technische en praktische uitdagingen.

De grootste valkuil? Geografische spreiding. Zodra je infrastructuur verspreid wordt over meerdere fysieke datacenters, bijvoorbeeld in Brussel en Antwerpen, ontstaat er onvermijdelijk latency. Dit fenomeen ontstaat doordat gegevens nu tussen fysieke locaties moeten reizen, via netwerken die onderhevig zijn aan afstand en dus vertraging opleveren.

Een dergelijke opstelling tussen deze twee steden veroorzaakt gemiddeld zo’n 4,8 ms TCP-latency. Niet catastrofaal op papier, in realiteit is het wel merkbaar: tragere laadtijden, vertraagde responstijden of kleine vertragingen in transacties die zich kunnen opstapelen tot een merkbaar verschil in performance.

Hoe los je deze latency dan op? De truc zit in slimme architectuur. Belangrijke componenten worden vaak per locatie gedupliceerd, zodat het meeste verkeer lokaal blijft en alleen replicatie- of synchronisatietaken over deze afstand gaan. Technieken zoals caching, load balancing en asynchrone replicatie helpen de impact van latency sterk te doen dalen.

En wat met data? Zodra je data persistent moet opslaan, bijvoorbeeld in een database, komen ook hier wat extra uitdagingen bij kijken. Als een gebruiker iets opslaat, zoals een bestelling in een webshop, moet diezelfde schrijfoperatie op beide locaties terechtkomen, zodat de gegevens overal gelijk, of anders gezegd ‘in sync’ blijven. Dit kan met sync writes (veilig maar trager) of via async replicatie (snel maar met het risico dat de replica niet volledig up-to-date is). In het geval van een storing bij async replicatie, kan dit dus betekenen dat je recent opgeslagen data verloren gaat. Concreet, beide opties hebben impact op de performance en complexiteit van je setup.

En dat is het paradoxale van redundantie: je kiest het om je hostingomgeving weerbaarder te maken tegen downtime of storingen, maar zonder de juiste afwegingen kan het de gebruikerservaring negatief beïnvloeden. Bij Level27 combineren we redundantie met een netwerk- en infrastructuurdesign dat latency minimaliseert, zodat je wel de zekerheid krijgt van spreiding zonder enige merkbare prestatieverliezen.

Waarom dan toch kiezen voor voldoende redundantie?

Redundantie binnen één datacenter biedt al een stevige basis. Maar voor applicaties die 24/7 beschikbaar moeten zijn, is dat soms niet voldoende. Denk aan e-commerceplatformen, SaaS-diensten of API-omgevingen, waar zelfs enkele minuten downtime directe gevolgen heeft. Een korte onderbreking kan leiden tot omzetverlies, reputatieschade en frustratie bij eindgebruikers. Die impact is vaak groter dan je zou denken: een misgelopen aankoop, een onbeschikbare dienst op een kritiek moment, of simpelweg een gebruiker die overstapt naar de concurrent. En laten we eerlijk zijn: gebruikers verwachten vandaag de dag absolute beschikbaarheid.

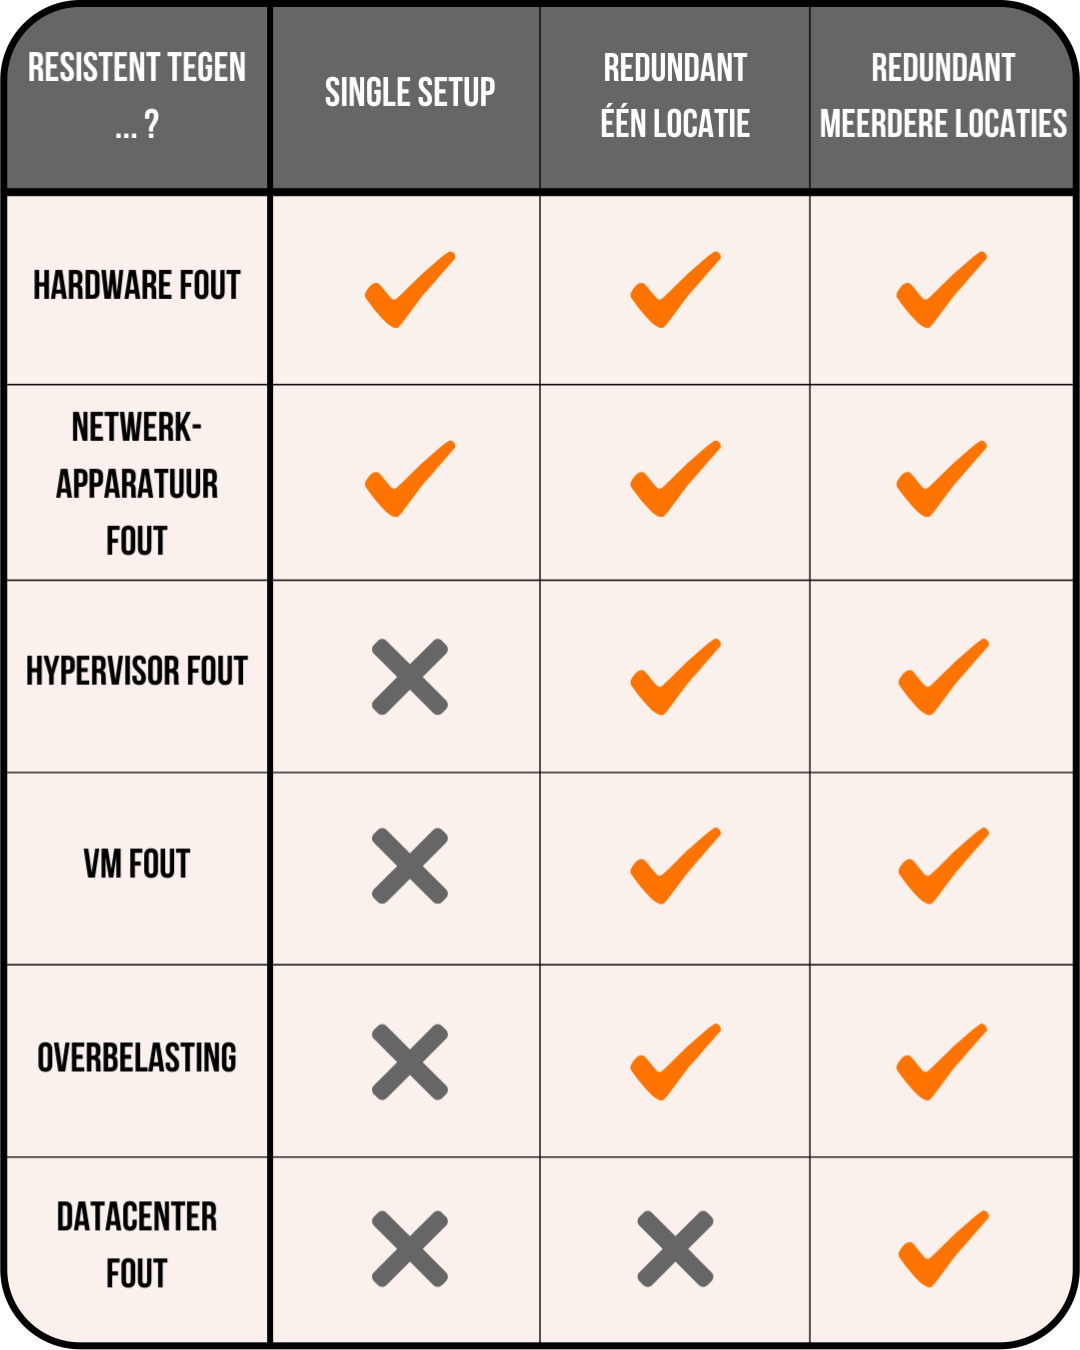
De oorzaken van downtime zijn uiteenlopend. Hardwareproblemen zoals defecte netwerkkaarten of storagesystemen, softwarefouten zoals corrupte configuraties of updates die verkeerd uitpakken, of overbelasting bij piekmomenten, zoals bij een populaire ticketverkoop. Zelfs externe fysieke incidenten in het datacenter, zoals brand of waterschade, kunnen de beschikbaarheid volledig onderbreken. Redundantie is dus geen overbodige luxe. Het is een weloverwogen keuze die je beschermt tegen onverwachte stilstand, en die de bedrijfscontinuïteit, betrouwbaarheid en klanttevredenheid ondersteunt. Maar belangrijker nog: de juiste vorm van redundantie kiezen, afgestemd op je applicatie en organisatie, is essentieel om het maximale eruit te halen. Wij hebben alvast deze tabel opgesteld zodat je beter begrijpt welke fouten al dan niet opgelost kunnen worden door de verschillende modellen.

image
author picture

Wij geloven in slimme redundantie: voldoende om jouw uptime te garanderen, zonder onnodige complexiteit en passend voor jouw budget.

Thomas

Marketing Manager

Onze aanpak bij Level27: Relaxed Online

Bij Level27 zit redundantie standaard verweven in onze infrastructuur. We werken uitsluitend met de meest betrouwbare datacenters in België, die de noodzakelijke garanties bieden om jouw beschikbaarheid te waarborgen. Elk datacenter is volledig uitgerust met dubbele stroom- en koelingssystemen, zodat jouw applicatie continu blijft draaien, zelfs bij onverwachte storingen.

Onze netwerkverbindingen gaan verder dan één enkele backup, met een drievoud aan capaciteit en connectiviteit blijft jouw applicatie altijd bereikbaar en verloopt de communicatie continu soepel. Bovendien beschikken onze datacenterzones over ruim voldoende beschikbare CPU- en geheugenresources, zodat we in een noodgeval onmiddellijk kunnen opschalen, zonder dat er tijd verloren gaat aan het zoeken naar extra capaciteit.

Daarnaast bieden we bij Level27 ook de mogelijkheid om je infrastructuur te verspreiden over twee of meerdere geografische locaties. We brengen je naar meerdere datacenters die exact hetzelfde doen als hierboven, maar dan onafhankelijk van elkaar. Deze opstelling verhoogt de beschikbaarheid en weerbaarheid van je hostingomgeving aanzienlijk. Want redundantie over meerdere datacenters betekent dat je applicatie niet afhankelijk is van één locatie of enkelvoudige componenten.

Graag combineren we technische betrouwbaarheid met praktische meerwaarde. Onze omgeving wordt 24/7 gemonitord om er zeker van te zijn dat de failover altijd werkt wanneer dat nodig is. We bieden volledige service op jouw omgeving, zodat alles soepel blijft draaien en ons gebruiksvriendelijke controlepaneel maakt het beheren van een complexe infrastructuur verrassend eenvoudig. Bovendien helpen we je bij het kiezen van het juiste managed server pack, zodat je SLA perfect aansluit bij jouw behoeften.

Wat is de beste setup voor jou?

Wij geloven niet in ‘one-size-fits-all’. Redundantie moet afgestemd zijn op jouw applicatie, jouw gebruikers en jouw businessmodel. Daarom helpen we je graag bij het maken van de juiste keuze. Wil je meer weten over hoe Level27 redundantie voorziet in onze hostingomgevingen? Boek dan meteen een vrijblijvend gesprek via de knop onderaan, we denken graag met je mee!

Boek een gesprek
Bel ons
CTA Image